20数年前に自分で設計・開発したC++用トランザクションモニターの設計思想を、Rustで作り直しています。それが「Ryumon(龍門)」です。この記事では、止まる前提で作るミッションクリティカルなシステムの考え方と、Ryumonの簡単な構成を紹介します。
この記事で分かること
- Ryumon(龍門)が生まれた経緯
- ミッションクリティカルなシステムが「止まる前提」で設計される理由
- クラウドとオンプレミスを組み合わせる考え方
- Ryumonの単純な構成
Ryumon(龍門)とは
元々20数年前に、私が設計・開発したC++用のトランザクションモニターがありました。
分散ネットワーク技術として設計・開発する知識があったことと、可用性を高めるために堅牢性を高める仕組みが欲しかったことが、きっかけです。ただ、TPモニターは非常に高価で、手に入るものではありませんでした。概念的な仕組みを聞いていただけの状態で、ソースコードも実は一切見たことがありません。
用語メモ: TPモニター トランザクション処理モニターのことです。複数の処理をひとまとまりとして扱い、途中で障害が起きても、データの一貫性を保てるようにする仕組みです。
一つだけ言えるのは、ミッションクリティカル系のシステム(SLA 99.999%以上)で高い堅牢性が求められるOSの開発をしていたので、これがどれだけ難しいかを理解していたことです。
某ゲーム会社の役員の方は、これを理解しておらず、「そんなのどのシステムでも当たり前だ」と言っていました。いくら説明しても伝わらない相手だと割り切り、その方とは距離を置くことにしました。
医療系のシステムや発電所のシステムも、ゲームも同じだと考える立場とは、会話がかみ合いません。「バグが出たので、システムを止めました」と謝って済むレベルのシステムと、それができないシステムとでは、設計思想がそもそもスタートから違うからです。
ミッションクリティカルなシステムの考え方
ミッションクリティカル系のシステムは、どうしてそこまで頑丈なのでしょうか。答えは、最初からダウンすることを前提に設計するからです。今、セキュリティの分野でトレンドの「ゼロトラスト」という考え方に基づいています。
どういうこと?と思うかもしれませんが、そのとおりです。システムが落ちるのは当たり前、という前提で最初から設計されています。矛盾しているように聞こえるかもしれませんが、初めからそう設計しているので、いつどの瞬間に落ちても、データの一貫性と継続性を保つ仕組みが入っているのです。
たとえば、次のようなことが起きても、段階を置いて継続性を保てるように、フェーズを分けて自動で復旧させます。
- Aサーバーがバグで落ちた
- AサーバーのCPUファンが壊れて停止した
- ネットワークカードが死んだ
- 地震で特定の地区が壊滅した
人間が一つずつコマンドを叩いたり、マニュアルを見ながら回復手段を使ったりはしません。フルオートで復旧させる仕組みが、そもそも入っています。定期的に「主」と「副」を切り替え、利用者には落ちたことにも気付かせないのが、本物のシステムです。
いよいよ本当にまずいときのために、テープ装置(DLTやLTOなど)や、「マイクロフィルム」という特殊なカメラで、データをネガという方式で、契約書などをすべて保管していることもあります。つまり、どのような状況に置かれても、何が何でも復旧するための備えです。もちろん、最悪のフェーズになれば、データが取れないこともあります。それでも、DRサイト(災害復旧サイト)で継続できる仕組みを、物理的に分散して構築しています。
用語メモ: DRサイト 災害復旧(Disaster Recovery)のための拠点です。本拠点が使えなくなったときに、業務を引き継ぎます。
よく冗談で、「システムは生き続けるけど、操作する人間が全員いないという状況になりそう」と言っていました。人間は二重化できませんからね(笑)。
もちろん、DRサイトにも、保守・運用をする部門を普段から配置しています。何とかなるように、組織からそのように作られているのです。これを聞いて、本当に「同じ」と言えるでしょうか。物事の表面だけを見た答えだということは、おわかりいただけるかと思います。
クラウドとオンプレミス
長々と話をしましたが、そのようなシステムを作るうえで、TPモニターが入っているのは、昔からのことです。
今はクラウドベースで行われている…はずなのですが、先日のマイクロソフトさんの障害で、そうではないことが明らかになりました。「マイクロソフト365から364にしろ」という辛辣な声も出ていましたが、私も被害を受けた一人として、苦笑いするしかありませんでした。ただ、現場は大変だったと思います。どんなに想定して二重化していても、連鎖的に崩壊していくものです。
これは、クラウドそのものの弱点と言ってよいでしょう。オンプレミスでの運用がなくならないのは、そういう理由もあると思います。自社と関係のない他社の事故に巻き込まれるのも、クラウドの特徴でしょう。
私は、ハイブリッド構成にして、DRサイトはオンプレミスで、最低限の運用が続けられるようにするのが一番よいと考えています。ただ、セキュリティもインフラもコストがかかるので、投資してもらえないのも事実です。湯水のように予算がある金融でもない限り、投資は渋られるのでしょう。事故が起こってからでは遅いのです。
Ryumonの単純構成図
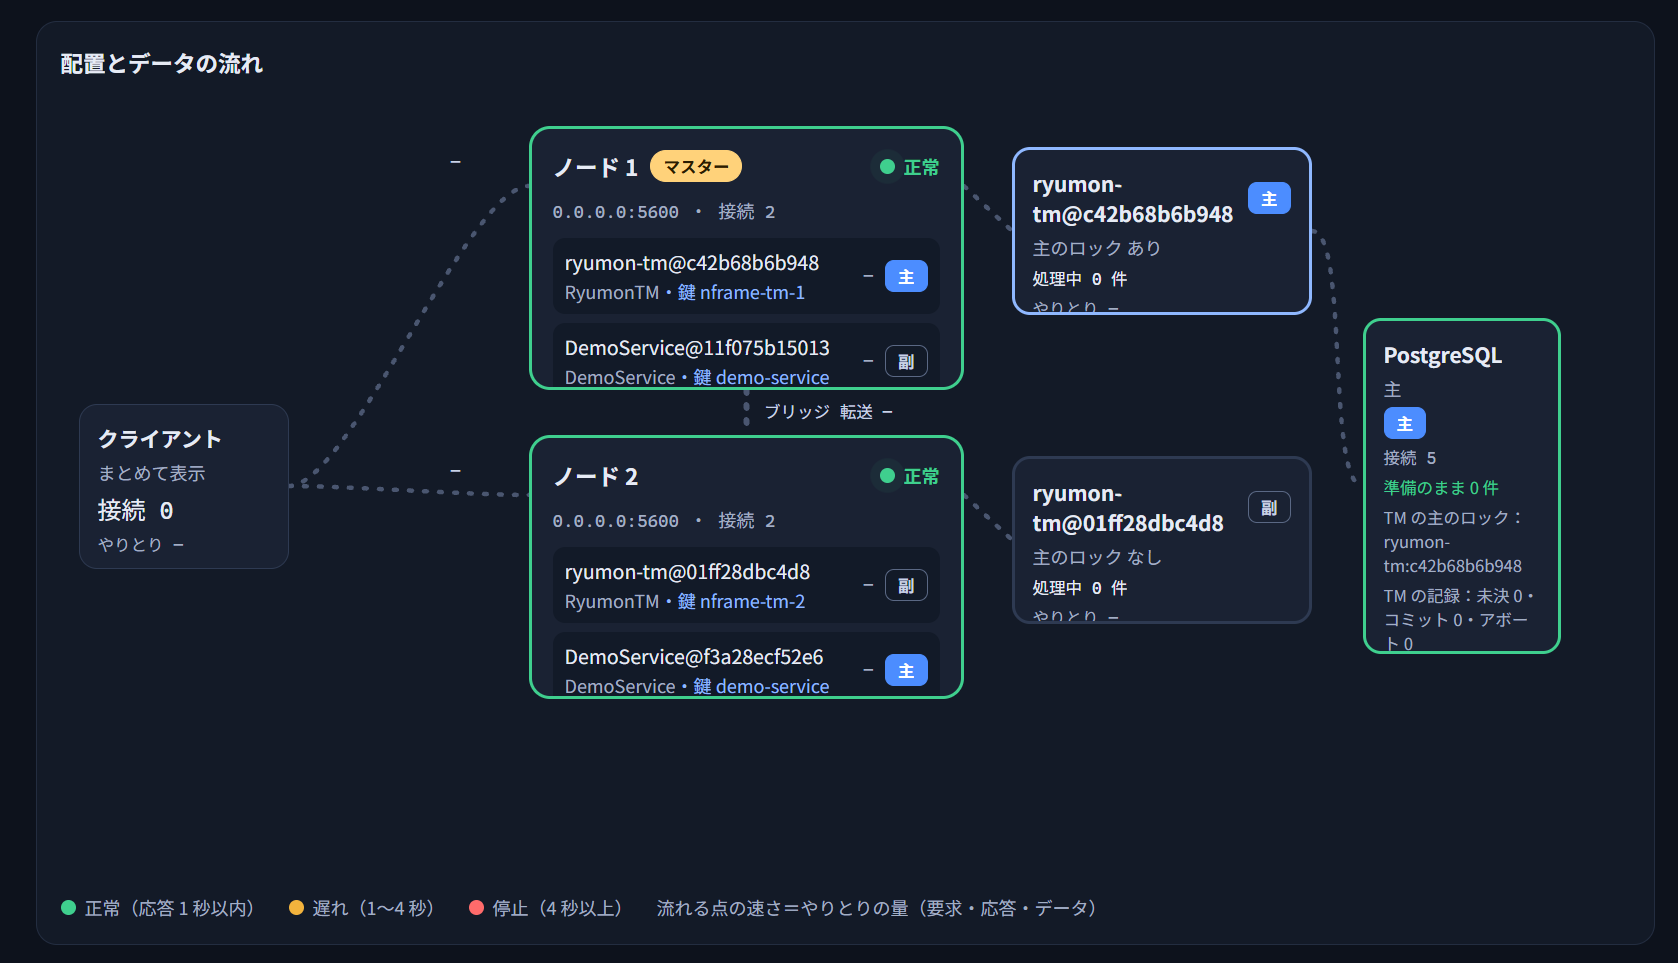
前置きが長くなりましたが、ここからがRyumonの解説です。次の図は、Ryumonの単純な構成です。
本来は、中継コアノードだけでも、数個のノードでアレイを作れます。また、クライアントとの間にロードバランサーを入れて負荷を分散したり、オーケストレーターであるケルベロスを入れて、ノードの起動を自動化したりもできます。
気が付きましたか? ryumon 自体は中継サーバなので複数のアプリサーバがその中で稼働させることができます。ここでは銀行用デモサーバとゲームサーバを並行稼働させているデモです。
実際の監視画面の様子
実装について
元々は、Windows NTのサービス(Unixの言い方ではデーモン)として稼働する、純然たるWin32 APIで実装した、非常に高速なものでした。ただ、さすがに書き直すのが面倒だったので、今回は言語にRustを採用し、設計思想だけを移植した形です。
まとめ
- ミッションクリティカルなシステムは、最初から「落ちる前提」で設計し、復旧もフルオートにする
- クラウドだけに頼らず、DRサイトをオンプレミスで持つハイブリッド構成が望ましい
- Ryumonは、昔作ったC++用のトランザクションモニターの設計思想を、Rustに移植したもの
今回はここまでとします。